隨著數(shù)字化轉型浪潮席卷全球,大數(shù)據(jù)已成為驅動企業(yè)創(chuàng)新與決策的核心引擎。一個完整的大數(shù)據(jù)架構并非單一技術堆砌,而是一個從數(shù)據(jù)獲取到深度學習的有機整體,其中存儲作為基石承載著整個數(shù)據(jù)處理流程。本文將系統(tǒng)解析現(xiàn)代大數(shù)據(jù)架構的核心層次,揭示數(shù)據(jù)處理與存儲服務如何協(xié)同支撐智能應用。
一、數(shù)據(jù)獲取層:多樣化的源頭活水
大數(shù)據(jù)架構始于數(shù)據(jù)獲取。這一層負責從異構數(shù)據(jù)源實時或批量采集數(shù)據(jù),涵蓋結構化數(shù)據(jù)(如關系型數(shù)據(jù)庫)、半結構化數(shù)據(jù)(如日志文件、XML/JSON)和非結構化數(shù)據(jù)(如文本、圖像、音視頻)。常用技術包括:
- 日志采集工具(如Flume、Logstash)用于實時流式日志收集
- 數(shù)據(jù)庫同步工具(如Sqoop、Debezium)實現(xiàn)傳統(tǒng)數(shù)據(jù)庫與大數(shù)據(jù)平臺間的數(shù)據(jù)遷移
- API接口與消息隊列(如Kafka、Pulsar)作為數(shù)據(jù)總線,解耦數(shù)據(jù)生產(chǎn)與消費
- 物聯(lián)網(wǎng)設備接入平臺處理傳感器時序數(shù)據(jù)
二、存儲基礎層:分層設計的持久化基石
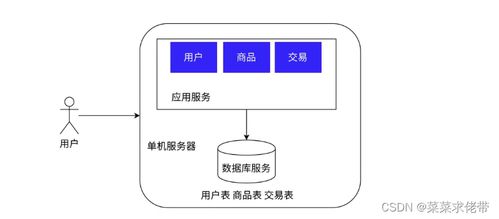
存儲是大數(shù)據(jù)架構的“地基”,其設計直接影響后續(xù)處理效率與成本。現(xiàn)代大數(shù)據(jù)存儲通常采用分層策略:
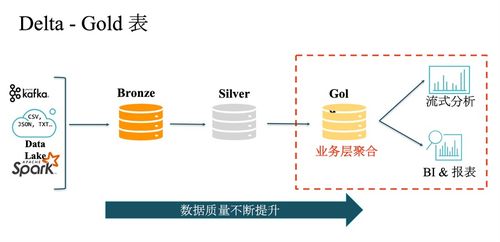
- 原始數(shù)據(jù)湖存儲:以HDFS、對象存儲(如AWS S3、阿里云OSS)為核心,以原始格式存儲全量數(shù)據(jù),保持數(shù)據(jù)保真度
- 預處理數(shù)據(jù)區(qū):存儲經(jīng)過清洗、標準化后的數(shù)據(jù),通常采用列式存儲格式(如Parquet、ORC)提升查詢性能
- 特征存儲:為機器學習專門優(yōu)化的存儲層,支持特征版本管理、在線/離線特征一致性
- 元數(shù)據(jù)管理:通過Hive Metastore、AWS Glue等工具管理數(shù)據(jù)資產(chǎn)目錄,實現(xiàn)數(shù)據(jù)可發(fā)現(xiàn)與可理解
三、數(shù)據(jù)處理與計算層:批流一體的智能引擎
在存儲基礎上,數(shù)據(jù)處理層將原始數(shù)據(jù)轉化為價值:
- 批處理引擎:以MapReduce、Spark為代表,處理海量歷史數(shù)據(jù),適用于ETL、報表生成等場景
- 流處理引擎:以Flink、Spark Streaming為核心,實時處理數(shù)據(jù)流,支撐監(jiān)控告警、實時推薦等需求
- 交互式查詢引擎:如Presto、Impala,提供亞秒級SQL查詢能力,賦能業(yè)務自助分析
- 圖計算引擎:如Neo4j、Spark GraphX,處理社交網(wǎng)絡、風控關系等圖結構數(shù)據(jù)
四、數(shù)據(jù)存儲服務層:面向應用的數(shù)據(jù)供給
這一層將處理后的數(shù)據(jù)以服務形式交付給應用系統(tǒng):
- 數(shù)據(jù)倉庫服務:如Snowflake、Redshift,提供企業(yè)級分析能力
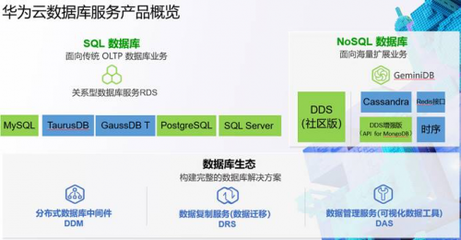
- NoSQL數(shù)據(jù)庫服務:包括文檔數(shù)據(jù)庫(MongoDB)、寬列數(shù)據(jù)庫(Cassandra)、時序數(shù)據(jù)庫(InfluxDB)等,支撐多樣化應用場景
- 搜索服務:如Elasticsearch,提供全文檢索與復雜聚合能力
- 數(shù)據(jù)API服務:通過RESTful或GraphQL接口暴露數(shù)據(jù),降低應用集成復雜度
五、深度學習與AI層:存儲之上的智能進階
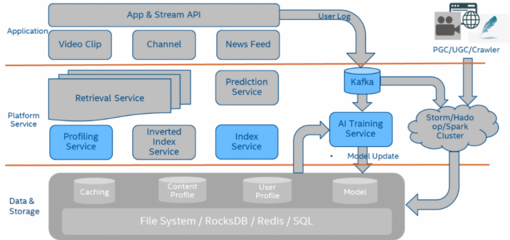
大數(shù)據(jù)架構的最終價值往往通過AI應用實現(xiàn),這一層與存儲深度耦合:
- 特征工程平臺:基于存儲層數(shù)據(jù),自動化進行特征提取、轉換與選擇
- 模型訓練平臺:利用Spark MLlib、TensorFlow等框架,在分布式存儲基礎上進行大規(guī)模模型訓練
- 模型存儲與版本管理:MLflow、ModelDB等工具專門管理模型資產(chǎn),確保可復現(xiàn)性
- 在線推理服務:將訓練好的模型部署為微服務,實時處理業(yè)務請求
六、架構演進趨勢:云原生與存算分離
當前大數(shù)據(jù)架構呈現(xiàn)兩大趨勢:
- 云原生架構:容器化部署(Kubernetes)、無服務器計算(AWS Lambda)與托管存儲服務深度融合,提升彈性與運維效率
- 存算分離架構:存儲與計算資源解耦,各自獨立擴展,避免傳統(tǒng)Hadoop架構中計算與存儲綁定的資源浪費
七、實踐建議:構建可持續(xù)演進的架構
企業(yè)構建大數(shù)據(jù)架構時應注重:
- 以業(yè)務價值為導向,避免技術驅動的過度設計
- 建立統(tǒng)一的數(shù)據(jù)治理體系,確保數(shù)據(jù)質量與安全
- 采用漸進式演進策略,從解決具體業(yè)務痛點開始,逐步擴展能力邊界
- 重視可觀測性建設,實現(xiàn)從數(shù)據(jù)采集到AI應用的全鏈路監(jiān)控
從數(shù)據(jù)獲取到深度學習的完整大數(shù)據(jù)架構,本質上是數(shù)據(jù)價值提煉的流水線。存儲作為貫穿始終的基礎設施,其設計哲學已從“存儲即目的”轉變?yōu)椤按鎯捶铡薄kS著計算存儲一體化芯片、新型非易失內(nèi)存等硬件革新,大數(shù)據(jù)架構將繼續(xù)演進,但核心邏輯不變:以高效可靠的存儲為基礎,通過分層處理將原始數(shù)據(jù)轉化為業(yè)務智能,最終賦能企業(yè)數(shù)字化轉型與智能化升級。